Актуальность: Q2 2026. Часть 2 из 2. Начало: Часть 1.
В первой части мы поставили двум пациентам диагноз. «Камера за $10» - детектор MobileNetV4-Conv-S, которому нужно 30 кадров в секунду на STM32N6. «Ассистент за 3 секунды» - 8B-модель в INT4 на флагманском NPU. Оба получили предварительное Работает. Но получили его с оговоркой, которую я тогда честно оставил висеть.
Помните те таблицы со столбцами «теория» и «реалистично»? Где между ними был разрыв в десятки, а то и сотни раз? STM32N6 по бумаге считает кадр за 0.33 мс, а в продукте - за 12 мс. Snapdragon NPU теоретически 4.4 микросекунды, реально 2.4 миллисекунды. Этот зазор я обещал закрыть. Вот мы и пришли его закрывать.
Только сразу предупрежу: я не люблю слово «ускорить» в вакууме. Ко мне приходят с «давайте ускорим инференс» примерно так же часто, как с «давайте сделаем красиво». И я отвечаю тем же неудобным вопросом, что и в первой части: ускорить - по какой метрике и ценой какой другой? Потому что embedded - это всегда одеяло, которое коротко с одной стороны. Натянули на время - оголилась энергия. Натянули на размер модели - просела точность.
Сквозная метафора у нас та же - «диета». Только в первой части мы считали, можно ли вообще похудеть. А здесь будем худеть по-настоящему: SIMD, NPU, квантование. И смотреть, где диета помогает, а где превращается в голодовку с потерей качества.
Почему нельзя просто «включить AVX-512» и разойтись
Первое, что я прошу запомнить, ещё до единой строчки кода: оптимизация живёт на четырёх разных этажах, и рычаг с одного этажа ломает метрику на другом.
Рис. 1. Четыре этажа оптимизации. Рычаг с нижнего этажа (SIMD) не лечит проблему верхнего (лишние кадры в пайплайне).
INT8 быстрее - но нужна калибровка, и кто-то должен подписать просадку точности. NPU быстрее на matmul - но дороже bring-up, и нужен редкий спец под конкретный SDK. SIMD ускоряет ядро вычисления - но не ускоряет доставку данных к этому ядру. Каждый рычаг тащит за собой счёт, который оплачивает соседняя метрика.
Отсюда правило, с которого начинается любая моя оптимизация: сначала SLA, потом инструмент. Не «возьмём AVX-512, потому что он есть», а «у камеры бюджет 15-20 мс на инференс, упираемся в X, лечим X». Что именно мерить первым - зависит от того, какую метрику продукт подписал кровью.
| Метрика | Что обычно помогает | Что обычно ломает | Мерить первым |
|---|---|---|---|
| Время инференса | SIMD, NPU, INT8, fused ops | Memory-bound, лишние копии | Профиль по слоям |
| Энергия | INT8, NPU, меньше DRAM | DMA, cold cache | мДж/инференс |
| Размер модели | quant weights, pruning | Точность | MB flash |
| Объём activations | INT8 act, in-place | Перекодирование | Peak RAM |
| Bandwidth | NHWC/NCHW layout, tiling | Random access | GB/s, cache miss |
| Точность | QAT, per-channel | W4 без калибровки | top-1 / mAP |
| Сложность внедрения | TFLite delegate, QNN | Ручные intrinsics | человеко-часы |
Таблица 1. Карта рычагов. Хорошее решение не максимизирует одну цифру, а закрывает SLA, не ломая соседнюю строку.
Это и есть методология этой части. Как и в первой, идём с двух сторон: сверху вниз - от продуктовой метрики («камере нужно 30 fps») к инструменту; снизу вверх - от железа («что физически умеет SIMD на этом ядре») к достижимому числу. Сходимся на честном ускорении, а не на цифре из white paper. Поехали с самого нижнего этажа - с того, чем ускоряют на CPU.
Зачем нам SIMD и почему он не панацея
Возьмём нашу «камеру» и на секунду представим, что NPU у нас нет - только CPU. Чем ускорять? Первый рычаг на CPU - это SIMD: SSE, потом AVX, потом AVX-512. Идея простая: одна инструкция работает не над одним числом, а над целой пачкой. Для GEMM - перемножения матриц, базового кирпича инференса - это прямое попадание.
Покажу на пальцах, как это выглядит в коде. Был наивный внутренний цикл - одно умножение за раз:
double cij = C[i][j];
for (uint32_t k = sk; k < sk + BLOCKSIZE; k++) {
    cij += A[i][k] * B[k][j];
}
C[i][j] = cij;
Стало - восемь double за инструкцию через AVX-512 (пример из практики):
__m512d c0 = _mm512_load_pd(C + i + j * n);
for (uint32_t k = 0; k < n; k++) {
    __m512d bb = _mm512_broadcastsd_pd(_mm_load_sd(B + j * n + k));
    c0 = _mm512_fmadd_pd(_mm512_load_pd(A + n * k + i), bb, c0);
}
_mm512_store_pd(C + i + j * n, c0);
И вот тут начинается интересное. Прогоним бенчмарк GEMM 5120×5120 и посмотрим на циклы.
| Вариант | Циклы | Ускорение vs naive |
|---|---|---|
| dgemm_basic | 1 154 120 417 | 1.0× |
| dgemm_avx512 | 144 941 094 | 7.96× |
| dgemm_blocked | 18 558 107 | 62.18× |
Таблица 2. GEMM 5120×5120, циклы (меньше - лучше). Источник: romz-pl/matrix-matrix-multiply.
Вот здесь я обычно останавливаю восторженного джуниора. Потому что в исходнике эти 62× любят приписать AVX-512 - и это ошибка, которую видно на ревью за пять секунд. 62× - это не «AVX-512 в вакууме». Это blocking плюс unroll плюс AVX-512, три рычага вместе. Сам AVX-512 в этом тесте даёт примерно 8×. Разница принципиальная: если вы заложили в план «AVX-512 = ×62», вы заложили туда чужой blocking, который ещё надо написать руками.
И даже эти честные ×8 - потолок, до которого вы в реальном инференсе не дотянетесь. Почему - в следующем разделе. А пока запомним картинку: SIMD ускоряет только участок ALU, кусок дороги под названием «арифметика».
Рис. 2. SIMD разгоняет только блок ALU. Доставка данных от DRAM до регистров - отдельная гонка, которую SIMD не ускоряет.
Куда девается обещанный ×8: memory wall
Вернёмся к нашему зазору «теория vs реалистично». Вот он, во плоти.
SIMD ускоряет исполнение в ядре. Но инференс - это не только исполнение. Это ещё и перекладывание данных: веса из памяти в кэш, из кэша в регистры, результат обратно. И пока ALU ждёт данные, ему всё равно, на сколько он быстрый.
Прикинем на салфетке (грубая модель задержки, порядок величин, в циклах):
| Режим | Exec | L2 | L3 | Memory | Σ | Реальное ускорение | Теория exec |
|---|---|---|---|---|---|---|---|
| Naive | 8 | 2 | 2 | 3.5 | 15.5 | 1.0× | 1.0× |
| SSE2 | 4 | 2 | 2 | 3.5 | 11.5 | 1.3× | 2.0× |
| AVX | 2 | 2 | 2 | 3.5 | 9.5 | 1.6× | 4.0× |
| AVX-512 | 1 | 2 | 2 | 3.5 | 8.5 | 1.8× | 8.0× |
Таблица 3. Прикидка автора, порядок величин. Колонка «теория» - что обещает ширина регистра. Колонка «реальное» - что остаётся, когда память не успевает кормить ALU.
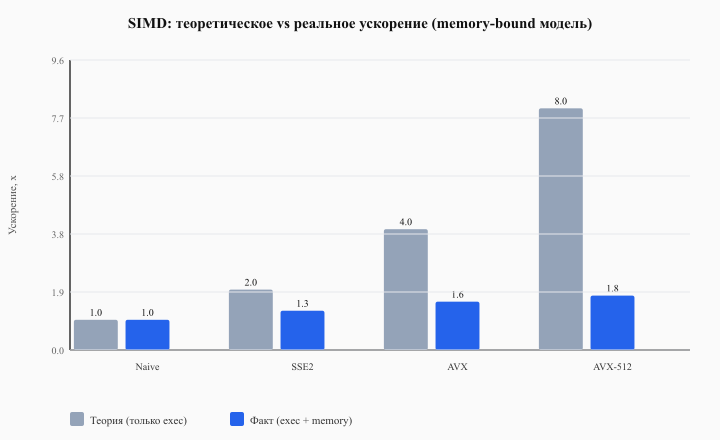
Рис. 3. AVX-512 на бумаге даёт ×8 по ALU. В memory-bound сценарии остаётся ×1.8. Цена вопроса - не инструкция, а L1/L2 и layout данных.
Видите, что произошло? Мы ужали колонку Exec в восемь раз - с 8 циклов до 1. А итог Σ упал всего с 15.5 до 8.5, потому что память (3.5) и кэши (2+2) никуда не делись. Восьмикратное ускорение арифметики дало меньше двукратного ускорения дела. Это и есть memory wall - стена, в которую упирается весь инференс, не только наш.
Это, кстати, тот же самый эффект, что мы видели в первой части у Horowitz: доступ к DRAM дороже INT8-умножения в тысячи раз. И тот же, что хоронил decode большой LLM на bandwidth. Узкое место - не арифметика, а память. Здесь оно просто в масштабе одного CPU-ядра.
У этой салфеточной прикидки есть формальное имя - roofline-модель: по горизонтали - арифметическая интенсивность (FLOP на байт из памяти), по вертикали - достижимый throughput. Пока ваш код левее излома «крыши», он memory-bound, и ширина регистра не решает ничего. Поэтому первый вопрос чек-листа в конце - не «какой SIMD», а «compute-bound или memory-bound».
Вывод одной строкой: прежде чем писать intrinsics, подберите размер тайла под ваш L1. На STM32F746 это 4+4 KB, на EPYC - 32+48 KB на ядро. Один и тот же код на этих двух машинах даст разный результат - потому что число, которое решает всё, живёт в кэше, а не в инструкции.
Правила кода для SIMD (Keep it simple, stupid!)
Раз уж мы выяснили, что разница между ×1.8 и ×0.9 решается не выбором инструкции, а тем, как написан внутренний цикл, - вот правила, которые я требую в hot path. Это не «советы на плакате». Это ровно та грань, за которой компилятор перестаёт векторизовать и всё ускорение испаряется.
- Внутренние циклы с фиксированной длиной - чтобы компилятор знал, что разворачивать.
- Один вход, один выход на итерацию - никаких боковых ветвлений.
- Branchless - ни одного
ifв горячем цикле. - Без вызовов функций внутри inner loop.
- Linear access - stride-1, последовательно по памяти, а не pointer chasing.
restrict/const/ выравнивание под ширину SIMD - чтобы загрузки были align, а не split.
Рис. 4. Анатомия SIMD-дружественного цикла. Нарушь любой пункт - и memory wall из прошлого раздела станет ещё выше.
Эти же паттерны вернутся дальше, когда дойдём до NPU и квантования. Запомните их как «инженерную гигиену» горячего пути: они повторяются сквозь всю embedded-работу.
А что с SIMD на микроконтроллере нашей камеры?
Наша «камера» живёт не на EPYC, а на STM32 - то есть на Cortex-M. И там SIMD другой: не AVX-512, а Helium (MVE) на ядрах Cortex-M55/M85. Векторы 128-битные, типы INT8/16/32, иногда FP16. Меньше размах, чем у серверного брата, - но это и не сервер.
Деталь, которую легко упустить при чтении даташитов: Helium есть только на M55/M85. Наш STM32N6 построен на Cortex-M55 - там MVE есть. А вот STM32F746 - это Cortex-M7, и там MVE нет вообще: только DSP-инструкции вида SMLAD, два INT16-умножения за такт. Именно на них CMSIS-NN выжимает свои измеренные 4.6× на свёртках против наивного кода - это и есть происхождение «×4» в таблице ниже, а не маркетинговая оценка.
| Параметр | AVX-512 (CPU) | MVE / Helium (MCU) |
|---|---|---|
| Платформа | Сервер / десктоп | MCU |
| Регистры | 512 bit ZMM | 128 bit |
| Энергия на операцию | выше | ниже |
| Пропускная способность | выше | ниже, но хватает для TinyML |
| Типы | FP64…INT8 | INT32…INT8 |
| Типичный выигрыш* | ×1.4 суммарно | ×4 на embedded CV |
Таблица 4. AVX-512 против Helium. *Суммарно с учётом памяти. ×4 на MCU - измеренные 4.6× CMSIS-NN на Cortex-M7 (CIFAR-10 CNN, INT8); тот же порядок даёт TFLite Micro. ×1.4 у AVX-512 - консервативная end-to-end оценка: чистый memory-bound GEMM в Таблице 3 давал ×1.8, реальный инференс с не-GEMM-слоями ещё ниже.
Здесь я ловлю частую подмену ожиданий. От MCU ждут поведения серверного CPU - и разочаровываются. Не надо. От MCU надо ждать ×4 на embedded CV при INT8 и аккуратном layout - и это отличный результат за свои деньги и милливатты. Обратите внимание на строку «энергия на операцию»: на батарейке MVE выигрывает у AVX-512 не пропускной способностью, а тем, что каждая операция дешевле. А для «камеры» батарея голосует наравне со временем.
Но честный SIMD на Cortex-M даёт нам в лучшем случае ×4-×5. В первой части мы видели, что между STM32F746 без ускорителя (4.5 секунды на кадр - Не работает) и STM32N6 с NPU (12 мс - Работает) разница почти в четыреста раз. Никакой SIMD такой разрыв не закроет. Значит, пора на следующий рычаг.
NPU: отдать matmul на сторону - и заплатить за доставку
NPU - это специализированный блок под INT8/INT4 matmul (STM32 Neural-ART, Hexagon, EdgeTPU). Пиковый throughput у него на порядки выше CPU, потому что он не универсальный, а заточен ровно под одну операцию инференса.
| Платформа | NPU peak | Источник |
|---|---|---|
| Snapdragon 8 Elite | ~45 TOPS* INT8 | оценка индустрии |
| STM32N657 Neural-ART | 600 GOPS | ST datasheet |
Таблица 5. Пиковый INT8 у NPU наших кандидатов. *Qualcomm публикует «+45% к Gen 3», не абсолютный TOPS, - поэтому 45 TOPS это оценка, а не даташит.
И вот тут - главная ловушка, из-за которой я и поставил у NPU честное «заплатить за доставку». Offload не бесплатный. Чтобы NPU посчитал слой, данные надо упаковать в его layout, проквантовать, прогнать через DMA, а результат - распаковать и деквантовать обратно.
Рис. 5. Жизненный цикл одного offload. Полезная работа - только блок compute. Pack, DMA и unpack - накладные, и на маленьком слое они съедают весь выигрыш.
Вот почему наша «камера» с MobileNetV4-S на STM32N6 от NPU выигрывает - там слои достаточно крупные, чтобы compute перекрыл pack/DMA/unpack. А вот игрушечная модель в 50 MAC на том же NPU может оказаться медленнее, чем на CPU: накладные на доставку больше самого вычисления. Это ровно тот же «парадокс GPU» из первой части - помните, как H100 на одном кадре MNv4-S не раскрывался? Та же логика, другой масштаб: ускоритель хорош, когда ему дают достаточно работы.
Вывод одной строкой: прежде чем закладывать NPU в latency-бюджет, посчитайте pack + DMA + unpack, а не только пиковый compute. Иначе на ревью получите «по даташиту 600 GOPS, а на нашей модели медленнее CPU».
Дорогие умножения: Штрассен и зачем мы вообще про него вспоминаем
Сделаем шаг на этаж алгоритмов. Инференс - это matmul, а matmul - это умножения и сложения. И умножение дороже сложения: больше логики в железе, больше циклов, а в INT8 ещё и риск overflow с расширением int32→int64. Логично спросить: а нельзя ли сделать меньше умножений?
Можно. Для блока 2×2 наивно нужно 8 умножений и 4 сложения. Штрассен разменивает одно умножение на кучу сложений: 7 mul, 18 add. Дальше есть схемы и поэкономнее.
| Алгоритм | Mul | Add |
|---|---|---|
| Naive | 8 | 4 |
| Strassen | 7 | 18 |
| Strassen-Winograd | 7 | 15 |
| Karstadt-Schwartz | 7 | 12 |
Таблица 6. Размен умножений на сложения для блока 2×2. 12 сложений у Karstadt-Schwartz - доказанный минимум для базы 2×2 (через смену базиса). Минус одно умножение стоит десятка сложений и памяти под промежуточные блоки.
Звучит соблазнительно, асимптотика у Штрассена и правда лучше - O(n^2.807). Но я редко вижу его в проде, и вот почему: overhead на рекурсию и память под промежуточные блоки делают его выгодным только на больших n. В CNN-свёртках на embedded чаще выигрывает связка im2col + GEMM + blocking, а не Штрассен.
Зачем тогда раздел? Чтобы вы знали, где тратятся дорогие умножения. AlphaTensor от DeepMind вообще ищет новые схемы умножения машинным перебором - красивая работа. Но в проде вы почти всегда раньше выиграете от INT8, чем от ручного Штрассена. К INT8 и переходим - это главный рычаг диеты.
Квантование: та самая ×4 «даром»
Вот мы и добрались до заголовка статьи. У «диеты» модели несколько методов:
- Pruning - режем связи.
- Quantization - меньше бит на вес и activation.
- Distillation - учим модель поменьше с помощью учителя.
- Weight clustering - меньше уникальных значений весов.
Для инференса я почти всегда начинаю с quantization, и конкретно с перехода FP32 → INT8. Потому что одним движением получаю сразу три выигрыша:
- ×4 меньше данных - четыре байта стали одним, меньше трафика по той самой шине, что упиралась в memory wall, и выше cache hit.
- ×4 больше операций на каждый lane SIMD или NPU - в регистр влезает вчетверо больше чисел.
- ×4-×20 меньше энергии на операцию - по Horowitz INT8-умножение это 0.2 pJ против 3.7 pJ у FP32.
То есть INT8 бьёт ровно по тому узкому месту - памяти и шине, - которое не лечил SIMD. Поэтому я и называю это «×4 даром»: вы не пишете руками blocking, вы меняете тип данных, и три метрики улучшаются разом.
Рис. 6. Конвейер квантования. Шаг Validate - не формальность: именно там диета может оказаться голодовкой.
Под капотом это affine-квантование, и формула простая:
x   = s · (x_q - z)        # dequant: из int обратно во float
x_q = round(x/s + z)       # quant: из float в int
Здесь s - scale (float), z - zero point (int). Маленькая, но важная деталь из практики: для свёрток per-channel s почти всегда лучше per-tensor. Один общий масштаб на весь тензор грубоват, а свой на канал ловит разброс весов точнее.
Дальше нужно выбрать режим квантования - и это разговор про то, сколько данных и времени вы готовы вложить.
| Режим | Данные для калибровки | Скорость | Точность |
|---|---|---|---|
| Dynamic | не нужны | быстрее FP32 | ~как FP32 |
| Static (PTQ) | unlabeled набор | максимум | -0.1…-1% top-1 |
| QAT | labeled train | высокая | ~как FP32 |
Таблица 7. Три режима квантования. PTQ - лучший компромисс «усилие/выигрыш» для большинства камер; QAT - когда просадку PTQ продукт не принял.
Где «даром» заканчивается
А теперь честная цена диеты. INT8 - почти бесплатно. Но соблазн же пойти дальше: W6, W4, ещё меньше. Посмотрим, что бывает.
| Модель (FP32 top-1) | W8 | W6 | W4 |
|---|---|---|---|
| ResNet18 (69.68) | 69.66 | 69.24 | 54.67 |
| MobileNetV2 (71.72) | 71.46 | 68.89 | 27.17 |
Таблица 8. Точность vs битность, per-channel MSE, Bayesian Bits. W8 почти бесплатно; W4 на MobileNet - обвал с 71.72 до 27.17.
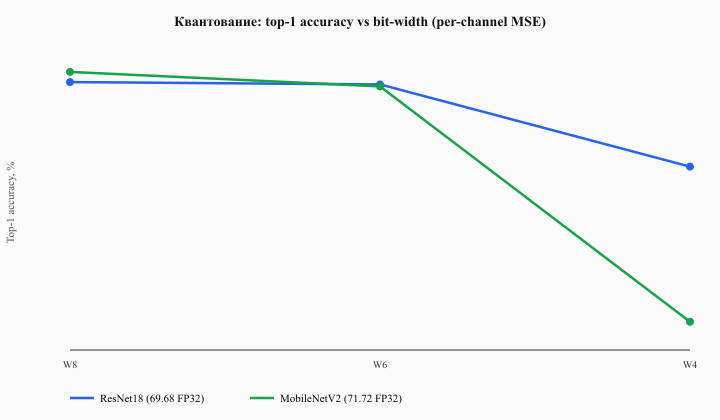
Рис. 7. W8 per-channel почти бесплатен. W4 на MobileNet без QAT - катастрофа. Это уже не диета, это голодовка.
Смотрите на строку MobileNetV2. W8 стоит 0.26 процентного пункта - это «даром». А W4 без QAT роняет точность с 71.72 до 27.17 - модель практически перестаёт работать. Причём ResNet18 переносит W4 куда легче - сеть тяжелее и избыточнее, ей есть чем жертвовать, - а компактный MobileNet нет. Чем сильнее модель уже посажена на диету архитектурно, тем хуже она терпит ещё и квантование.
Вывод одной строкой: INT8 даёт ×4 по данным и throughput почти даром; W4 без QAT - это потеря качества, которую должен подписать архитектор продукта, а не инженер «по-тихому». Та самая мысль из первой части: где quality = retention, такие решения не принимают втихую.
Стоп. А как же «ассистент» на INT4?
Внимательный читатель сейчас поймает меня за руку: в первой части наш «ассистент» получил Работает именно на 8B в INT4. А тут я только что показал, что W4 - обвал. Противоречия нет, и разница поучительна.
Обвал в Таблице 8 - это W4 «в лоб»: один scale на канал, компактная CNN, у которой избыточности почти не осталось. LLM-веса квантуют иначе. Во-первых, weight-only: в 4 бита ужимают только веса, activations остаются в FP16/INT8 - а именно веса, как мы считали в первой части, душат decode по bandwidth. Во-вторых, погруппно: свой scale на каждые 64-128 весов, а не на канал. В-третьих, методы класса GPTQ и AWQ подбирают округление по калибровочным данным, а не просто режут хвосты. Итог: на 7-8B-моделях это стоит единицы процентов качества - и возвращает те самые ×4 по памяти и шине, без которых модель в телефон не влезает.
Заметьте, правило то же, что у ResNet против MobileNet, только масштабом больше: большая избыточная модель терпит диету лучше маленькой. 8B-LLM в W4 живёт; MobileNetV2 в W4 умирает.
«Конвертация модели - это не простой, а часть оптимизации»
Этот раздел я держу специально для разговора с менеджером, который смотрит на план и спрашивает: «а почему два дня на конвертацию модели, она же готовая?» Отвечаю числами.
Для квантованного Y = XW + b в INT8 часть слагаемых - константы на всё время inference. Их не нужно считать на каждый кадр:
z_Y- zero point выхода;(s_b/s_Y)(b_q - z_b)- вклад смещения;z_X · Σ W_q- сумма весов на zero point входа;p · z_X · z_W- произведение zero point'ов (p- длина суммирования, внутренняя размерность matmul).
Всё это считается offline, один раз, при конвертации модели. А в runtime на горячем пути остаётся только INT8 MAC плюс дешёвое домножение на scale.
Y_q = f( Σ(X_q · W_q), scales, zero_points )   # INT8 MAC - hot path
Y   = s_Y · (Y_q - z_Y)                          # dequant - cold
Алгебра целиком - Jacob et al., CVPR 2018.
Вот это и есть ответ менеджеру: «конвертация модели» - не idle time перед запуском. Это этап, где мы перетаскиваем дорогие вычисления из runtime (где они стоят милливатт на каждом кадре) в offline (где они бесплатны). Те два дня - часть оптимизации, а не накладная к ней.
XNOR-Net: диета до состояния скелета
Раз уж говорим про диету, покажу её крайнюю точку - чтобы было видно, где граница разумного. Бинарные сети: веса ±1, иногда и входы ±1. Свёртка тогда превращается из FP-умножений в XNOR + popcount - две дешёвые битовые операции.
| Тип | Память | Вычисления | AlexNet top-1 |
|---|---|---|---|
| FP32 | 1× | 1× | 56.6% |
| XNOR-Net | 32× | 58×* | 44.2% |
Таблица 9. XNOR-Net против FP32. *58× - только conv на CPU, не end-to-end (Rastegari et al., 2016). Top-5: 69.2% против 80.2% FP32.
Рис. 8. Свёртка как XNOR + popcount + порог. Дёшево по железу - дорого по точности.
Цифры красивые: 32× по памяти, 58× по вычислениям на conv. Но посмотрите на последнюю колонку - top-1 падает с 56.6% до 44.2%. Минус двенадцать процентных пунктов. Это не диета, это уже скелет.
И здесь я снова возвращаю разговор к продукту. XNOR имеет смысл там, где питания почти нет (ultra-low-power), а -12 пунктов точности допустимы - какой-нибудь грубый wake-up детектор. И не имеет смысла там, где качество = удержание пользователя. Наша «камера» с детекцией, скорее всего, такой просадки не переживёт. Поэтому для неё потолок диеты - INT8, а XNOR остаётся экзотикой для очень узкой ниши.
Иногда быстрее не matmul, а порядок работ
Мы всю дорогу спускались по этажам вниз - к инструкциям и битам. Теперь резко поднимемся на этаж приложения, потому что там часто лежит самый дешёвый выигрыш, про который все забывают, копаясь в intrinsics.
Рис. 9. Полный пайплайн «камеры». Пользователь ощущает всю цепочку, а не блок Infer.
Вспомните бюджет «камеры» из первой части: 33 мс на кадр - это на всё, а не на нейросеть. Capture, preprocess, infer, postprocess, действие. И вот что часто экономит больше, чем разгон самого infer:
- ROI crop до инференса - кормим сеть не всем кадром, а областью интереса. Меньше пикселей - меньше MAC, причём бесплатно.
- Skip frames - не каждый кадр нужен инференсу; «ощущаемый» FPS можно держать, считая реже.
- Fused preprocess на NPU/DSP - не гонять данные туда-сюда между блоками.
- Double-buffering без лишних
memcpy- захват следующего кадра параллельно с обработкой текущего. - Batch=1 для realtime против batch>1 для throughput - разные задачи, разный выбор.
Вывод одной строкой: пользователь ощущает end-to-end latency, а не «время одного conv». Поэтому профилировать и оптимизировать надо весь пайплайн - иначе разгоните на ×2 ту часть, что занимала 10% бюджета.
Закрываем зазор: «камера» после всех рычагов
Пора собрать всё в одну таблицу и вернуться к обещанию из начала. Берём ту же «камеру» - MobileNetV4-Conv-S, 0.2 GMAC, 0.4 GFLOP на кадр - и смотрим, что дали рычаги.
| Платформа | Стек | Время инференса | 30 fps? |
|---|---|---|---|
| EPYC CPU FP32 | naive | ~0.3 мс | да |
| EPYC CPU FP32 | AVX-512 blocked | ~0.05 мс* | да |
| Snapdragon NPU INT8 | QNN/HTP | ~2.4 мс | да |
| STM32F746 FP32 | без SIMD | ~4.5 с | нет |
| STM32N6 INT8 | Neural-ART | ~12 мс | да (с запасом на post) |
Таблица 10. MNv4-S после оптимизаций. *Прикидка от GEMM-бенча, не end-to-end TFLite.
Вот он, закрытый зазор. В первой части STM32N6 в столбце «реалистично» показывал 12 мс против 0.33 мс теории - и я обещал объяснить разницу. Теперь объяснение собрано: 0.33 мс - это чистый compute по даташиту NPU, а остальные ~11.5 мс - всё то, что мы разобрали в этой части: pack/DMA/unpack вокруг offload, чтение весов, оркестрация runtime. Зазор - не «недооптимизированный код», а цена доставки данных, и она предсказуема заранее. 12 мс - это и есть «реалистично», и в 33-мс бюджет «камеры» оно влезает с запасом на postprocess. Первый пациент окончательно получает Работает.
А STM32F746 без NPU как был Не работает (4.5 с), так и остался. Чтобы превратить 4.5 секунды в 33 миллисекунды, нужно ускорение примерно в 140 раз. SIMD на Cortex-M даёт ×4, квантование - ещё ×4; вместе ×16, и взять недостающий почти порядок на этом ядре неоткуда. Это ровно та мысль из первой части: NPU здесь не «приятная опция», а единственный способ. Рычаги Части 2 её только подтвердили числом.
А что с энергией - батарея ведь голосует отдельно?
| Сценарий | Энергия | Комментарий |
|---|---|---|
| Horowitz MAC only | 0.046 мДж | нижняя граница, «голые» умножения |
| STM32N6 measured (MNv2 proxy) | ~6 мДж | ST wiki |
| FP32 на MCU без NPU | >> батарея | NoGo |
Таблица 11. Энергия «камеры» после диеты, INT8, класс MNv4-S. Разрыв между 0.046 и 6 мДж - это снова data movement, а не арифметика.
И снова та же история, что в первой части: между «голыми» MAC (0.046 мДж) и реальным замером (6 мДж) - больше сотни раз, и весь этот разрыв съедает движение данных, DMA, чтение весов. INT8 помог тем, что данных стало вчетверо меньше, - но физику memory wall он не отменил, только подвинул. Поэтому FP32 на MCU без NPU остаётся честным NoGo по энергии, даже если бы вдруг влез по времени.
Что мы сознательно не трогали
Инженерная честность требует назвать границы. Эта часть - про рычаги общего назначения на CPU/MCU/NPU. За кадром осталось намеренно:
- CUDA / TensorRT, CoreML, NNAPI - vendor-specific гайды, каждый тянет на отдельную статью.
- Sparsity 2:4 (structured pruning) на H100-class - отдельная большая тема серверного железа.
- LLM-specific - speculative decoding, квантование KV-cache; про «ассистента» мы взяли только W4-веса, остальное - другой разговор.
- Автотюнинг (AutoTVM, XNNPACK) - где компилятор сам ищет лучший layout и тайл.
Это не «забыли». Это «не помещается в одну часть честно». Куда копать - ссылки ниже.
Чек-лист: что делать на ревью и в коде
- Снять профиль: задача compute-bound или memory-bound? (roofline / perf)
- Подобрать L1/L2 tile size под ваш кэш, не под цифры из tutorial
- SIMD: inner loop branchless, aligned, linear, фиксированной длины
- INT8 PTQ → validate → если просело, QAT или per-channel
- NPU: заложить в latency-бюджет pack + DMA + unpack, а не только peak compute
- Не путать AVX-512 (~8×) с полной GEMM-оптимизацией (~62×) - на ревью это видно
- W4 / XNOR - только когда метрику качества подписал product owner
- LLM-веса в W4 - weight-only + group-wise (GPTQ/AWQ), не per-channel «в лоб»
- Мерить end-to-end, а не один
conv2dв ноутбуке - Сверить с маркетингом вендора: «×10 в white paper» → «×4.7 у нас на стенде»
Источники
- GEMM benchmark (romz-pl)
- Roofline model (Williams et al., CACM 2009)
- CMSIS-NN (Lai et al., 2018)
- TFLite Micro
- Matrix Multiplication, a Little Faster (Karstadt, Schwartz, JACM 2020)
- AlphaTensor (DeepMind)
- Quantization (Jacob et al., 2018)
- Bayesian Bits (NeurIPS 2020)
- GPTQ (Frantar et al., 2022)
- AWQ (Lin et al., 2023)
- XNOR-Net (Rastegari et al., 2016)
- Horowitz 2014 energy (PDF)
- STM32N657X0 / Neural-ART
- STM32Cube.AI performances
- MobileNetV4
Две части вместе дают то, что нужно на ревью: сначала Go/NoGo по цифрам (Часть 1), потом рычаги ускорения без самообмана. Наши двое прошли весь путь: «камера» дошла до Работает на STM32N6 + INT8 + Neural-ART, «ассистент» - на 8B INT4 с NPU. А зазор «теория vs реалистично», который мы оставили висеть в первой части, теперь закрыт числом.