Ко мне приходят с двумя запросами. Первый: «30 кадров в секунду на устройстве за 10 долларов». Второй: «ответ пользователю за три секунды, не за минуту». Оба звучат разумно. Оба ломаются, если начинать с выбора фреймворка, а не с цифр.
Дальше эти двое - назовём их «камера за $10» и «ассистент за 3 секунды» - пройдут со мной через всю статью как два пациента на приёме. Я не буду разбирать их по очереди и забывать. Я тащу обоих через каждый шаг: метрику, платформу, расчёт, энергию, деньги. К финалу мы увидим, кто доходит до Работает, а кто упирается в физику и получает честное Не работает.
Я обычно поступаю невежливо и сразу спрашиваю: какой бюджет на инференс - по времени, памяти, энергии и деньгам. Не потому что люблю спорить. Потому что embedded-цикл длинный, а ошибка на этапе выбора платформы стоит квартал переписывания. Лучше я задам неудобный вопрос сейчас, на салфетке, чем мы вместе найдём ответ через полгода на этапе оптимизации.
Поэтому это не обзор железа. Это методология выбора до первой строчки кода, рассказанная как путь от запроса к вердикту. Сквозная метафора - «диета»: мы урезаем не модель ради моды, а обещания, которые физически не сходятся с железом.
Зачем инференс на устройстве, если облако дешевеет?
Прежде чем считать наших двоих, ответим на честное возражение менеджера: «зачем вообще edge, если облако дешевеет каждый год?» Вопрос правильный, и я отвечу на него числами, а не лозунгом про приватность.
Цена inference в облаке падает. Epoch AI показывает устойчивый тренд вниз по $/token для LLM. Зачем тогда edge?
Затем, что халява заканчивается. Тот же Epoch AI (май 2026) считает: спрос на токены растёт примерно ×10 в год, а предложение (железо + эффективность чипов) - всего ×3.4 в год. Это называется compute crunch. Когда он наступает, большие модели в облаке дорожают, а массовый пользователь уходит на меньшие и локальные модели. Edge - не альтернатива облаку «для гиков». Это запасной аэродром экономики, когда облачный токен снова станет дорогим.
И ещё одна причина, которую менеджер обычно недооценивает: P&L пользователя и P&L продукта - разные таблицы. Edge перекладывает деньги из одной в другую, и кому-то от этого становится сильно легче.
| Что меняет работа на устройстве | Что получает пользователь | Что получает бизнес |
|---|---|---|
| Конфиденциальность | Данные не уходят в дата-центр | Меньше юридических рисков |
| Задержка | Отклик без похода по сети туда-обратно | Приятнее в работе, лучше удержание |
| Трафик | Не платит за передачу каждого кадра | Меньше расходов на каналы, приём и хранение данных |
| Энергия (иногда) | Посчитать на месте дешевле, чем гонять по радиоканалу | Ниже OpEx дата-центра |
Таблица 1. Что даёт перенос инференса на устройство - и почему это разговор не про «облако дорого».
Вывод: edge - не про «облако дорого». Edge - про контроль над метриками, которые облако не гарантирует. Держим это в голове, когда дальше будем мерить наших двоих.
Рис. 1. Два контура инференса. Продуктовая разница - в задержке, приватности и стоимости трафика.
Знакомимся с пациентами поближе
Прежде чем лечить, поставим диагноз. Оба запроса звучат как «сделайте красиво», а нам нужны числа, в которые они на самом деле упираются.
«Камера за $10»: 30 fps на edge CV
Разговор почти всегда одинаковый:
Менеджер: Нужна детекция на видео. 30 кадров в секунду. Плата - 10 долларов.
Инженер: Хорошо. Сколько миллисекунд на кадр? Какая модель? INT8 или FP32? Есть NPU?
Менеджер: Главное - чтобы работало.
Инженер: Тогда сначала считаем. 30 fps = 33 мс на кадр. И туда входит всё.
Ключевая ловушка здесь в слове «всё». 33 мс - это не «время нейросети». Это бюджет на захват кадра, preprocess, infer, postprocess и собственно действие по результату. Нейросети из этого бюджета достанется хорошо если половина. Запомним цифру: у нашей камеры на сам инференс - порядка 15-20 мс, не больше.
«Ассистент за 3 секунды»: LLM на устройстве
Второй пациент терпеливее. Пользователь готов ждать три секунды, не минуту. Но вопрос здесь не «какая модель самая умная», а сколько GFLOP уходит на токен и, главное, куда влезают веса.
И вот тут я сразу обязан сказать неприятное. Полноразмерная фронтир-модель класса Kimi K2.6 (1 трлн параметров total, спецификация Moonshot AI) на устройстве за $10 - это Не работает по памяти. Не «пока не оптимизируем», а физически. Почему - посчитаем ниже честно, на салфетке. Пока просто отметим: «ассистент» придётся либо ужимать до 8B-класса, либо отправлять в облако. Третьего железо не предлагает.
Двух пациентов завели. Теперь не лечим наугад, а строим методологию.
Почему ошибку нельзя будет откатить
Один вопрос, который я задаю раньше всех технических: насколько дорого будет ошибиться? В вебе плохой выбор откатывается за спринт. В embedded перестроение вектора - это месяцы. Производственный цикл, BOM, сертификация, редкие специалисты под конкретный NPU.
Рис. 2. Жизненный цикл embedded-продукта. Память и throughput считаются на первом блоке, не на третьем.
Смотрите на эту цепочку внимательно. Если на этапе Выбор платформы мы не посчитали память и throughput для нашей «камеры», то Оптимизация превращается не в «подкрутить пару коэффициентов», а в «переписать всё с нуля на другом чипе». Для продукта с трёхлетней поддержкой это не оптимизация - это новый проект.
Мне не нравится подписная модель «всё в облаке» именно поэтому: продукт становится заложником чужого SLA на горизонте, который ваш BOM не переживёт. Это моя личная позиция, и я её не прячу - но обоснована она тем же горизонтом трёх лет, а не вкусовщиной.
Отсюда правило: считаем до R&D. А чтобы считать, нужны два маршрута навстречу друг другу.
Методология: сверху вниз + снизу вверх
Два контура нужны одновременно, и наши пациенты пройдут через оба.
Сверху вниз: тренд → пользователь → продукт → метрики (latency, fps, privacy, cost). Это маршрут «камеры»: бизнес сказал «30 fps за $10», мы спускаемся до чисел.
Снизу вверх: рынок железа → платформа → ускорители → фреймворк → реализуемость. Это маршрут «ассистента»: смотрим, что физически умеет железо, и поднимаемся до вопроса «а влезет ли вообще».
Рис. 3. Два маршрута сходятся на деплое. Точка схода - это и есть Работает/Не работает.
Плохие проекты застревают в одном контуре: либо «нарисовали красивый UX и поздно узнали про память», либо «выбрали модный чип и не поняли, зачем». Хорошие сходятся на Работает/Не работает до R&D. Чтобы сойтись, нужен общий язык - числа. Заведём их.
Метрики, которые фиксируем до кода
Это словарь, на котором дальше говорим про обоих пациентов. Без него «быстро» и «дёшево» - пустые слова.
| Метрика | Единица | Зачем |
|---|---|---|
| GIPS / FGIPS | ops/s | Верхняя граница compute |
| Bandwidth | byte/s | Узкое место памяти |
| Latency | мс, с | UX |
| Memory | KB, MB, GB | Влезет ли модель |
| CapEx | $ | Цена железа |
| OpEx | $/год, $/GIPS | Электричество, DC, поддержка |
| Energy | мДж/инференс, Вт·ч | Батарея |
Таблица 2. Метрики, которые называем числом до первой строчки кода. «Камера» живёт в строках Latency/Energy/CapEx, «ассистент» - в Memory/Bandwidth.
Маленькое, но важное занудство, без которого таблицы начинают врать. GIPS - все инструкции. FGIPS - именно float-операции. Для INT8 на NPU считаем GOPS отдельно: смешивать INT8-GOPS с FP32-FGIPS в одной ячейке без пометки - классическая ошибка, которая потом даёт «ускорение в 40 раз на бумаге».
И главная формула, на которой держится вся прикидка (грубая, порядок величин):
t_inference ≈ MAC_count / throughput_eff
где throughput_eff - эффективный throughput, не маркетинговый пик из слайда. Для FP32: 1 MAC ≈ 2 FLOP. Эту формулу мы сейчас применим к обоим пациентам - но сначала выберем класс платформы, потому что число throughput_eff живёт именно в железе.
Выбор класса платформы
У каждого класса своя сильная сторона и своя стена, в которую он упирается. Я держу в голове такую карту.
| Класс | Сильная сторона | Слабая сторона | Типовая модель |
|---|---|---|---|
| MCU | Цена, энергия | Память KB-MB | TinyML, keyword |
| CPU | Универсальность, latency | FP32 дорог | Pre/post, малые сети |
| GPU | Throughput | Шина, TDP | Batch CV |
| TPU/NPU | INT8 matmul | Latency offload, SDK | CV, LLM 7-8B quant |
Таблица 3. Классы платформ. Обратите внимание: слабая сторона почти всегда - память или шина, а не «мало флопсов».
Как я выбираю класс на практике - не по логотипу вендора, а по дереву решений. Первый вопрос всегда про память, а не про скорость.
Рис. 4. Дерево выбора класса. Первая развилка - память. Если модель не влезла, остальные вопросы не имеют смысла.
Прогоним пациентов по дереву. «Камера»: модель маленькая, влезает; SLA - десятки мс; ветка ведёт в CPU + NPU или MCU + NPU. «Ассистент» на 8B: впритык влезает на флагман с NPU; SLA - секунды; та же правая часть дерева. А фронтир-Kimi на первой же развилке получает Не работает по памяти и уезжает в облако. Дерево не дало ему ни единого шанса дойти до вопроса про latency.
Вывод: класс платформы определяет память, не логотип вендора. Теперь подставим конкретные чипы.
Кандидаты: инженерные данные vs маркетинг
Беру якоря - самые сильные в своём классе, а не «что лежало на столе». Добавлю два GPU для контраста: потребительский RTX 3070 (то, что стоит дома у разработчика) и профессиональный дата-центровый H100 SXM (то, на чём крутят прод). Так будет видно, за что именно платят ×50 цены.
| Платформа | Модель | Кэш on-chip | RAM (data) | Цена* | Мощность (актив.) |
|---|---|---|---|---|---|
| CPU Server | AMD EPYC 9965 (192c) | L1 32+48 KB/core | до 4 TB | ~$14 000 | 500 W (TDP) |
| Mobile SoC | Snapdragon 8 Elite | L1 32+48 KB/core | LPDDR5X до 24 GB | ~$190 | ~5-10 W (SoC) |
| GPU consumer | NVIDIA RTX 3070 | L2 4 MB | 8 GB GDDR6 | ~$499 | 220 W (TDP) |
| GPU datacenter | NVIDIA H100 SXM | L2 50 MB | 80 GB HBM3 | ~$25-30 тыс. | 700 W (TDP) |
| MCU + NPU | STM32N657X0 | L1 32+32 KB | 4.2 MB SRAM | ~$10 | ~0.2-0.3 W |
| MCU | STM32F746NGH6 | L1 4+4 KB | 240 KB | ~$10 | ~0.3 W |
*Цены - порядок величин по открытым прайсам и дистрибьюторам, Q2 2026. RTX 3070 - MSRP 2020; H100 SXM - вторичный/новый рынок 2026.
Таблица 4. Кандидаты по классам. Два кандидата за $10 - наши будущие хосты для «камеры».
И сразу контраст, ради которого я и взял два GPU. Между RTX 3070 ($499, 8 GB) и H100 ($25 тыс., 80 GB HBM3) разница в цене - ×50, а в bandwidth памяти - ×7.5 (448 GB/s против 3.35 TB/s). За «профессиональность» платят именно памятью и шиной, не FP32-числом. Эта мысль аукнется нам дважды: на «парадоксе GPU» с маленькой моделью и на decode большой LLM.
Throughput (теория из документации, без SIMD/NPU если не указано)
| Платформа | FP32 (FGIPS) | Tensor INT8 (TOPS) | Bandwidth |
|---|---|---|---|
| EPYC 9965 | 1728 | - | DDR5, сотни GB/s |
| Snapdragon 8 Elite | 112 | ~45 TOPS* | LPDDR5X, ~77 GB/s |
| RTX 3070 | 20 300 | 162 (dense) | 448 GB/s |
| H100 SXM | 67 000 | 3958 | 3350 GB/s |
| STM32N657 | 1.28 | 0.6 (NPU) | внутр. SRAM |
| STM32F746 | 0.088 | - | внутр. SRAM |
Таблица 5. Пиковый throughput по докам. Это потолок, не то, что вы получите в продукте - реальные числа будут ниже.
*Snapdragon NPU: оценка 45-80 TOPS INT8 по сторонним бенчмаркам; Qualcomm не публикует абсолютный TOPS в product brief, только «+45% к Gen 3».
STM32N6 NPU: 600 GOPS, 288 MAC/cycle, 3 TOPS/W - datasheet, ST blog.
GPU: RTX 3070 (Ampere) - 20.3 TFLOPS FP32, 162 TOPS INT8 tensor. H100 SXM (Hopper) - 67 TFLOPS FP32, 3958 TOPS INT8 tensor, 3.35 TB/s HBM3. По INT8 H100 быстрее RTX 3070 в ×24, и почти вся разница - в тензорных ядрах и шине, а не в FP32 (там разрыв ×3.3).
Числа разложены. Пора применить формулу к первому пациенту.
Считаем «камеру»: MobileNetV4-Conv-S
Возьмём для «камеры» честный якорь - реальную сеть детекции/классификации. Берём официальные из arXiv:2404.10518:
| Параметр | Значение |
|---|---|
| Параметры | 3.8 M |
| MACs (224×224) | 0.2 G |
| FLOPs (2×MAC) | 0.4 GFLOP |
Таблица 6. MobileNetV4-Conv-S по первоисточнику. 0.4 GFLOP на кадр - это та цифра, что идёт в формулу.
Расчёт времени инференса
Подставляем t = MAC / throughput_eff, а точнее t = 0.4 GFLOP / throughput, и прогоняем по всем кандидатам сразу - чтобы увидеть, где наша камера живёт, а где задыхается:
t = 0.4 GFLOP / throughput
| Платформа | t (теория) | t инференса (реалистично) | Сеть туда-обратно** | Итого на кадр |
|---|---|---|---|---|
| EPYC CPU FP32 (облако) | 0.23 мс | ~0.3-1 мс | ~20-100 мс | ~20-100 мс |
| Snapdragon CPU FP32 (на устройстве) | 3.6 мс | ~5-10 мс | нет | ~5-10 мс |
| Snapdragon NPU INT8 (на устройстве) | 8.9 мкс | ~2.4 мс | нет | ~2.4 мс |
| RTX 3070 FP32 (локальный бокс) | 20 мкс | ~0.3-0.8 мс | нет / LAN менее 1 мс | ~1 мс |
| H100 FP32 (облако) | 6 мкс | ~0.2-0.5 мс | ~20-100 мс | ~20-100 мс |
| STM32F746 FP32 (на устройстве) | 4.5 с | Не работает | нет | Не работает |
| STM32N6 NPU INT8 (на устройстве) | 0.67 мс | ~12 мс | нет | ~12 мс |
Таблица 7. Время одного кадра MNv4-S по платформам. Между теорией и реальностью - framework overhead, тепло и pre/post (разрыв на 1-2 порядка). А для облачных платформ сеть туда-обратно перекрывает само вычисление в десятки-сотни раз - и именно она, а не скорость GPU, решает, влезет ли кадр в бюджет 33 мс.
**Сеть туда-обратно (round-trip), порядок величин: Wi-Fi/LAN ~1-5 мс, 5G ~10-30 мс, 4G ~30-50 мс, дальний дата-центр ~50-150 мс. Плюс джиттер и потери пакетов, которые в realtime бьют больнее среднего числа.
Прикидка для STM32N6: ST wiki даёт MobileNetV2 224×224 @ 23.2 мс, 6 мДж. MNv4-S в ~1.5× легче по MAC → ~12-15 мс - порядок величин.
И вот тут новый столбец говорит то, что одни «миллисекунды на GPU» скрывают. У нашей «камеры» бюджет на кадр - 33 мс на всё. Облачный H100 считает кадр за полмиллисекунды, но чтобы кадр до него доехал и вернулся ответ, нужно ещё 20-100 мс только на сеть. То есть самый быстрый по вычислению вариант не влезает в бюджет из-за дороги, а не из-за арифметики. STM32N6 за $10 считает «медленно» (12 мс), но без сети - и спокойно укладывается в 33 мс. Это ровно та же мысль, что и в разделе про edge vs облако, только теперь подтверждённая числом: для realtime по кадрам сеть - не «деталь», а главный пожиратель бюджета.
Смотрите, что произошло с нашим первым пациентом. Та же сеть, тот же кадр - и разница между STM32F746 без NPU и STM32N6 c NPU в десятки тысяч раз. 4.5 секунды против 12 мс. Это не «допишем код и ускорим», это другой класс задачи. NPU здесь не «приятная опция», а единственный способ уложить 30 fps в десять долларов.
Парадокс GPU, про который я предупреждал
А теперь то место, где маркетинг особенно громко спорит с физикой. H100 за $25 тыс. на одном кадре MNv4-S обгонит RTX 3070 в лучшем случае в полтора раза - хотя по бумаге быстрее в ×3.3. Почему? Маленькая модель при batch=1 не нагружает ни тензорные ядра, ни шину. Время съедают запуск ядра и pre/post, а не вычисления. GPU раскрываются только на батче. Для realtime-детекции по одному кадру дорогой DC-ускоритель - деньги на ветер. Запомните этот эффект: ровно та же логика «упёрлись не в compute» вернётся в разделе про большую LLM, только с другим знаком.
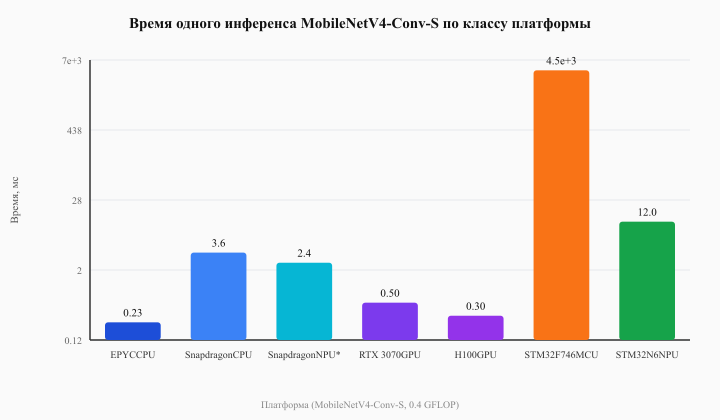
Рис. 5. Логарифмическая шкала. Разрыв между MCU без NPU и MCU+NPU - десятки тысяч раз. Это не «оптимизация кодом», это другой класс задачи.
Промежуточный вердикт по «камере». 30 fps на $10 реалистично на STM32N657 + NPU + INT8, если inference укладывается в ~15-20 мс и postprocess не жадный. На STM32F746 без NPU - Не работает. Первый пациент получил предварительное Работает - но мы ещё не посчитали энергию, а батарея голосует отдельно.
Энергия: почему «голые MAC» врут
Соблазн посчитать энергию «камеры» как количество MAC умножить на джоули за операцию велик. И он обманчив. Возьмём канонические числа из Horowitz, ISSCC 2014 (45 nm, порядок величин):
| Операнд | Умножение | Сложение | Доступ к памяти |
|---|---|---|---|
| INT8 | 0.2 pJ | 0.03 pJ | L1 8 KB: ~10 pJ |
| INT32 | 3.1 pJ | 0.1 pJ | L1 32 KB: ~20 pJ |
| FP16 | 1.1 pJ | 0.4 pJ | L1 1 MB: ~100 pJ |
| FP32 | 3.7 pJ | 0.9 pJ | DRAM: ~1300-2000 pJ |
Таблица 8. Энергия операций по Horowitz. Обратите внимание на последний столбец: доступ к DRAM дороже INT8-умножения в тысячи раз.
Теперь посчитаем «голую» арифметику нашей камеры и сравним с реальным замером.
Прикидка для MNv4-S (только MAC, INT8)
E_compute = 0.2 GMAC × (0.2 + 0.03) pJ ≈ 0.046 мДж
Измерение на STM32N6 (MobileNetV2, ST wiki)
E_measured = 6 мДж / инференс
Разница - больше чем в сто раз. Откуда? Не из умножений. Из движения данных: память, DMA, CPU-оркестрация, чтение весов из внешнего flash.
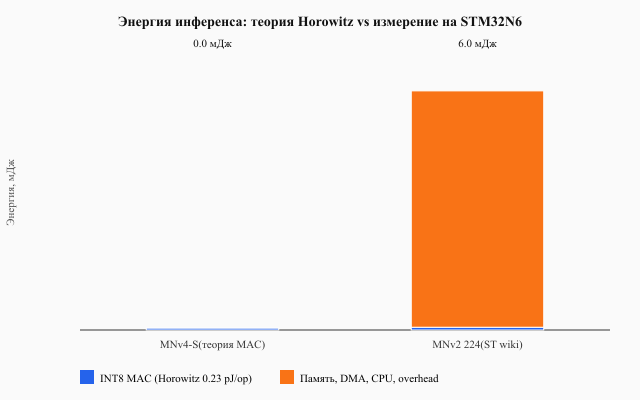
Рис. 6. «Голые» MAC по Horowitz - крошечный столбик. Реальный инференс - память, DMA, CPU-оркестрация, внешний flash. Horowitz прав: data movement съедает бюджет.
Вывод одной строкой: оптимизировать только ALU без layout и памяти - как считать калории, забыв про доставку еды. Эту мысль - «узкое место не арифметика, а память» - подержите в голове: следующий пациент доведёт её до масштаба дата-центра.
Считаем «ассистента»: почему фронтир-LLM - job для дата-центра, а не для розетки
Возвращаемся ко второму пациенту, которому я ещё в начале выписал Не работает. Пора доказать это числом, а не на словах. Возьмём конкретный фронтир-якорь - Kimi K2.6 (апрель 2026), самую сильную открытую модель в Epoch Capabilities Index. Архитектура известна, и это удобно: считаем на реальных числах, а не на «оценках индустрии».
| Параметр | Значение | Источник |
|---|---|---|
| Total параметров | 1 трлн (MoE, 384 эксперта, 8+1 на токен) | Moonshot AI |
| Active на токен | 32 млрд | там же |
| Веса в INT4 | 500 GB* | 1T × 0.5 байт |
| KV-cache | FP8 | Epoch AI |
| Контекст | 256K | спецификация |
| Внимание | MLA | спецификация |
Таблица 9. Kimi K2.6 в цифрах. Строка «500 GB весов» - это и есть приговор для устройства за $10.
*Чекпойнт на Hugging Face весит ~594 GB: эксперты в INT4 (QAT), но attention и embedding-слои - в BF16. Для салфетки оставляем круглые 500 GB - на вердикт лишние 20% не влияют.
Прикидка на салфетке (по модели Epoch AI)
Сначала compute на токен в decode (прикидка автора, по формуле Epoch):
FLOP_token_weights = 2 × N_active = 2 × 32 млрд = 64 GFLOP/токен
64 GFLOP на токен - вроде немного. Но вот в чём фокус: decode у такой MoE не упирается в compute. Он упирается в bandwidth. На каждый токен надо прочитать все 500 GB весов из HBM. На стойке GB200 NVL72 с HBM 576 TB/s:
t_bw ≈ 500 GB / 576 TB/s ≈ 0.87 мс/токен
Это совпадает с расчётом Epoch (868 мс на 1000 токенов). То есть ответ в 1000 токенов прокачивает через HBM ~500 TB данных - модель не столько считает, сколько возит веса туда-обратно.
Узнаёте? Это тот же самый эффект, что у «камеры» на GPU и у Horowitz с DRAM. Узкое место - не арифметика, а память и шина. Только теперь он в масштабе целой стойки.
Вывод одной строкой: фронтир-LLM в decode - это memory-bound задача. Та же мысль, что и в Рис. 6, только умноженная на дата-центр.
Так почему всё-таки Не работает на edge?
Теперь самый короткий и самый честный расчёт в статье. Сравним, где должны жить 500 GB весов и сколько памяти есть у наших edge-кандидатов:
| Где живут 500 GB весов | Доступная память | Вердикт |
|---|---|---|
| STM32N6 (MCU за $10) | 4.2 MB SRAM | Не работает на 5 порядков |
| Смартфон-флагман | до 24 GB LPDDR5X | Не работает на 20× |
| GB200 NVL72 | 13.4 TB HBM | дом для модели |
Таблица 10. Куда влезают веса Kimi K2.6. Edge-устройства проигрывают не в скорости, а в самом наличии места.
Kimi K2.6 на устройстве за $10 - Не работает. Не «пока не оптимизируем». Физически Не работает по памяти, на пять порядков. Я обещал это в начале - вот доказательство на салфетке.
А деньги-то тут при чём?
Любопытная развязка: per-token цена у такой модели смешная. Moonshot отдаёт K2.6 по $4 за 1M выходных токенов, ответ в 1000 токенов - $0.004, около 0.36 ₽. Розетка пользователя тут вообще ни при чём.
Цена вопроса - доступность железа. Epoch оценивает пропускную способность одной GB200 NVL72 на K2.6 в ~400 000 токенов/с (откалибровано по данным SemiAnalysis InferenceX), а мировой потолок - 0.5-20 млрд токенов/с. Спрос растёт быстрее. Отсюда тот самый compute crunch из начала статьи: большие модели дорожают, и тем ценнее становится локальный или малый инференс - тема Части 2.
А что наш «ассистент» всё-таки может?
Фронтир мы похоронили честно. Но пациент пришёл не за фронтиром, а за «ответом за три секунды». Давайте спустимся по лесенке моделей и найдём ту, что реально влезает - ведь вопрос был про SLA, а не про лидерборд.
| Модель | Параметры | RAM INT4 | Реалистичная платформа | 3 с? |
|---|---|---|---|---|
| Kimi K2.6 class | 1T total / 32B active | ~500 GB | Server GPU (NVL72) | В облаке |
| Qwen3-8B class | 8.2 B | ~4-5 GB | Mobile SoC NPU | Возможно с INT4 |
| Phi-4-mini / Gemma 3 4B | ~4 B | ~2 GB | Mobile / edge GPU | Да |
| TinyLLM | менее 1B | менее 1 GB | MCU+NPU | Только короткий ответ |
Таблица 11. Лесенка LLM под SLA «3 секунды». Чем ниже спускаемся, тем реальнее edge - ценой качества ответа.
Остановимся на 8B - это разумный компромисс между «умеет» и «влезает». Прикидка decode 8B INT4 на Snapdragon NPU (берём эффективные ~15 TOPS из заявленных ~45):
~16 GFLOP/token → 100 tokens = 1.6 TFLOP
t ≈ 1.6×10^12 / (15×10^12) ≈ 0.1 с (теория по compute)
Теория по compute говорит 0.1 секунды. Но мы только что похоронили Kimi ровно за это: decode упирается не в compute, а в bandwidth. Применим тот же урок к себе. На каждый токен NPU должен прочитать все ~4.5 GB весов из LPDDR5X (~77 GB/s):
t_token ≈ 4.5 GB / 77 GB/s ≈ 60 мс → ~17 токенов/с
За 3 секунды - ~50 токенов: короткий абзац, не эссе. Реальные замеры 8B INT4 на флагманах дают те же 15-25 токенов/с - салфетка по bandwidth попадает в реальность куда точнее салфетки по TOPS. Сверху добавятся prefill (промпт в 1000 токенов - это ~16 TFLOP, ещё около секунды на NPU) и KV-cache (~0.5 GB RAM на 4K контекста).
Итого: SLA «3 секунды» выполним, если ответ короткий, а контекст скромный. Нужно 150-200 токенов за те же 3 секунды - спускаемся на ступень ниже, к 4B-классу (Phi-4-mini, Gemma 3 4B): ~2 GB весов → ~35 токенов/с. Второй пациент жив - просто не в том виде, в каком пришёл.
Рис. 7. Путь токена в on-device LLM. Decode-петля - там, где живёт bandwidth, и там же тикают наши 3 секунды.
Итог по «ассистенту» двойной. Qwen3-8B INT4 на флагмане с NPU - Работает: короткий ответ (~50 токенов) за 3 с реален, длинный - уже нет. Полный Kimi K2.6 на телефоне за $10 - Не работает, физически по памяти. Какой из двух вердиктов нужен продукту - решает не инженер, а тот, кто отвечает за качество ответа и приватность. Наше дело - показать, что выбор есть и где он упирается.
Технико-экономическое обоснование: цена одного инференса
Менеджеру не нужен FGIPS. Ему нужна строка в P&L: сколько стоит один инференс и кто за него платит. Доведём обоих пациентов до денег - это финальный анализ, ради которого всё и затевалось.
Допущения (прикидка автора, Q2 2026): электричество 7 ₽/кВт·ч, курс ~90 ₽/$, горизонт 3 года. Цифры - порядок величин, не оферта.
«Камера»: edge CV, одна камера 30 fps
Главная хитрость edge в том, что он переносит затраты из OpEx в CapEx. Заплатил один раз за чип - дальше почти бесплатно. Посчитаем это «почти».
Энергия на инференс (STM32N6, ST wiki, ~6 мДж):
C_energy = 6 мДж × (7 ₽ / 3.6e6 Дж) ≈ 1.2e-8 ₽/инференс
CapEx, размазанный по 3 годам при 30 fps:
N = 30 × 86400 × 365 × 3 ≈ 2.84e9 инференсов
C_capex = $10 / 2.84e9 ≈ 3.5e-9 $/инференс ≈ 3.2e-7 ₽/инференс
Теперь сравним стоимость владения одной камерой за 3 года: локально против «гонять тот же поток в облако».
| Способ | CapEx | Энергия/трафик за 3 года | Итого 3 года | Нужна связь? |
|---|---|---|---|---|
| Edge (STM32N6) | ~900 ₽ ($10) | ~48 ₽ (2.3 кВт·ч/год) | ~950 ₽ | нет |
| Cloud (доля H100) | 0 | ~$219/3y GPU* + трафик | ~20 000 ₽+ | да, постоянно |
Таблица 12. TCO одной камеры за 3 года. Edge выигрывает порядок не на цене чипа, а на отсутствии постоянного OpEx.
*H100 в облаке ~$2.50/час (типичная аренда 2026, порядок величин). Один поток 30 fps не грузит GPU - даже при упаковке ~300 потоков на карту выходит ~$73/год/поток только за GPU, плюс трафик и backend.
Вывод одной строкой: для распределённых низконагруженных потоков edge дешевле облака в ~20 раз на горизонте 3 лет. Облачный GPU простаивает, а вы платите за простой.
«Ассистент»: один ответ Kimi K2.6 (8000 вход : 1000 выход)
Здесь edge физически не тянет (см. выше про 500 GB весов), поэтому считаем облако. Берём профиль запроса из модели Epoch AI.
Управляемый API (цены Moonshot $0.95/1M вход без кэша, $4.00/1M выход):
C_in  = 8000 × $0.95/1e6 = $0.0076
C_out = 1000 × $4.00/1e6 = $0.0040
C_api = $0.0116 ≈ 1.05 ₽ за ответ
| Способ | $/ответ | ₽/ответ | Когда выгодно |
|---|---|---|---|
| API Moonshot (Kimi K2.6) | $0.0116 | ~1.05 ₽ | старт, низкий объём |
| Self-host floor (H100, 120B class) | ~$0.0013 | ~0.12 ₽ | высокая загрузка, свой SRE |
| On-device Qwen3-8B INT4 | ~0 (маржа) | ~0 | приватность, нет сети, ниже качество |
Таблица 13. Цена одного ответа LLM по способам деплоя. Три разных бизнес-сценария, три разные строки P&L.
Self-host floor взят из бенчмарка SemiAnalysis InferenceMAX: GPT-OSS-120B на H100 - ~$0.14 за 1M токенов (на Blackwell-стойках NVIDIA показывает и $0.02-0.03). Для Kimi K2.6 (1T/32B) цена выше, но порядок тот же.
Вывод одной строкой: API дешевле на старте, но при миллионах запросов self-host окупает CapEx H100 ($25-30 тыс.) и обгоняет API примерно на порядок по цене ответа - а на Blackwell-стойках разрыв ещё больше. А когда придёт compute crunch, дешёвый путь для массового пользователя - меньшая on-device модель, где маржинальная цена ответа стремится к нулю. Круг замкнулся: тот же тренд, с которого мы начали.
Экономика владения: скрытые строки P&L
Прежде чем выносить вердикт, признаем то, что обычно забывают в смете. Техническое совершенство окупается, только когда в расчёт попадают все строки, а не одна цена чипа:
- CapEx - BOM + NRE платформы
- OpEx DC - серверы, электричество, SRE
- OpEx пользователя - трафик, батарея, замена устройства от перегрева
- Стоимость редких спецов - NPU bring-up vs «подключить API»
- Горизонт поддержки - 3 года без смены условий для пользователя
| Платформа | CapEx изделия | CapEx/$ за 3y (прикидка) | OpEx edge | OpEx cloud |
|---|---|---|---|---|
| EPYC server | $14k+ | высокий | низкий/изделие | высокий |
| Snapdragon | $190 | средний | низкий | средний |
| STM32N6 | $10 | низкий | очень низкий | нужен backend |
Таблица 14. Скрытые строки P&L по платформам. Cloud выигрывает быстро, edge - вдолгую.
Вывод: cloud выигрывает по time-to-market. Edge выигрывает по TCO на горизонте 3 лет для mass-market устройства с миллионным тиражом.
Вердикт: куда дошли оба пациента
Мы провели «камеру» и «ассистента» через метрики, дерево платформ, расчёт времени, энергию и деньги. Соберём весь путь в одну таблицу Работает/Не работает - это и есть точка схода двух маршрутов из методологии.
| Платформа | Edge CV 30 fps («камера») | LLM 3 с («ассистент») | Условия успеха |
|---|---|---|---|
| MCU без NPU | Не работает | Не работает | - |
| MCU + NPU | Работает (INT8, малая модель) | Не работает | MNv4/YOLO-nano class |
| Mobile CPU | Возможно | Сложно | FP16/INT8, малая модель |
| Mobile NPU | Работает | Работает (7-8B quant) | runtime + quant |
| GPU consumer (RTX 3070) | Работает (но overkill для $10) | Сложно (8 GB лимит) | desktop/edge-box, батч |
| GPU datacenter (H100) | Работает | Работает (батч, 80 GB) | CapEx/OpEx, не edge |
Таблица 15. Сводный Работает/Не работает. «Камера» закрывается на $10 с NPU; «ассистент» жив только в ужатом 8B-виде или в облаке.
Если коротко: камера за $10 - Работает на STM32N6 + NPU + INT8. Ассистент за 3 секунды - Работает, но не фронтиром, а 8B-моделью на NPU флагмана, либо через облачный API. А полноразмерный Kimi на устройстве за десять долларов так и остался Не работает - и это не пессимизм, это арифметика памяти.
Что не покрыли в этой части
Инженерная честность требует назвать границы. Здесь мы сознательно не трогали:
- Server-side TPU и AMD/Intel-ускорители как отдельные якоря (в примере только NVIDIA).
- Multi-GPU и батч-планирование на H100/NVL72 (это бюджет throughput, не latency).
- Точный roofline-анализ под вашу модель (нужен профайлер, не даташит).
- Юридические аспекты on-device vs cloud (GDPR, отраслевые нормы).
- Выбор конкретного runtime (TFLite, ONNX, NNAPI, QNN) - это Часть 2.
Чек-лист: что делать завтра утром
- Зафиксировать SLA: fps / latency / качество / сценарий отказа
- Посчитать MAC/FLOP модели (netron, paper, ptflops)
- Проверить: влезают ли веса + activations + KV-cache в RAM
- Выбрать класс платформы по памяти, не по TOPS
- Сделать прикидку
t = MAC / throughput_eff- три сценария: оптимист, реалист, пессимист - Посчитать энергию: Horowitz compute + измеренный overhead с похожего стенда
- Свести CapEx/OpEx на 3 года
- Посчитать цену одного инференса/ответа (энергия + амортизация CapEx, или $/токен API)
- Сравнить TCO edge vs cloud на горизонте 3 лет, а не цену чипа
- Работает/Не работает до выбора фреймворка
- Один прототип, одна метрика, один датасет - измерить, не спорить
Дальше
В Части 2 разберём, как выжать реалистичный throughput: SIMD и L1, NPU offload, квантование INT8, и почему AVX-512 на бумаге ×8, а в продукте ×1.8. То есть займёмся ровно тем зазором между «теорией» и «реалистично» из наших таблиц, который мы здесь честно оставили висеть.
Источники
- Epoch AI: LLM inference price trends
- Epoch AI: Is a compute crunch coming? (модель инференса Kimi K2.6)
- Kimi K2.6: спецификация и веса (Moonshot AI)
- Kimi API: цены (Moonshot AI)
- SemiAnalysis InferenceX / InferenceMAX: $/1M токенов по железу
- NVIDIA: Blackwell в бенчмарках InferenceMAX
- Horowitz 2014: Computing's energy problem (PDF)
- MobileNetV4 (arXiv:2404.10518)
- AMD EPYC 9965 specs
- STM32N657X0 datasheet
- STM32N6 blog (600 GOPS NPU)
- STM32Cube.AI measured performances
- Snapdragon 8 Elite product brief
- NVIDIA RTX 3070 specs
- NVIDIA H100 datacenter GPU
- Kimi K2: Open Agentic Intelligence (arXiv:2507.20534)